让 Codex 做 SEO 调研,几分钟内就能得到关键词、搜索量、难度、意图和推荐页面类型。真正难的是后续取舍:这些词是不是客户会搜?应该做产品页还是文章?相近关键词要不要拆成不同页面?
这些问题不能交给一张看起来完整的表格自动回答。更稳妥的分工是:人定义业务边界,Codex 负责采集和整理证据,再由人审核聚类和页面规划。
先写研究计划,再批量查词
SEO 调研的第一步不是查询关键词,而是交代业务边界。假设项目目录中有两个文件:
product-scope.csv:产品范围、服务地区、客户类型和不能承接的需求;keyword-schema.xlsx:最终希望保留的字段。
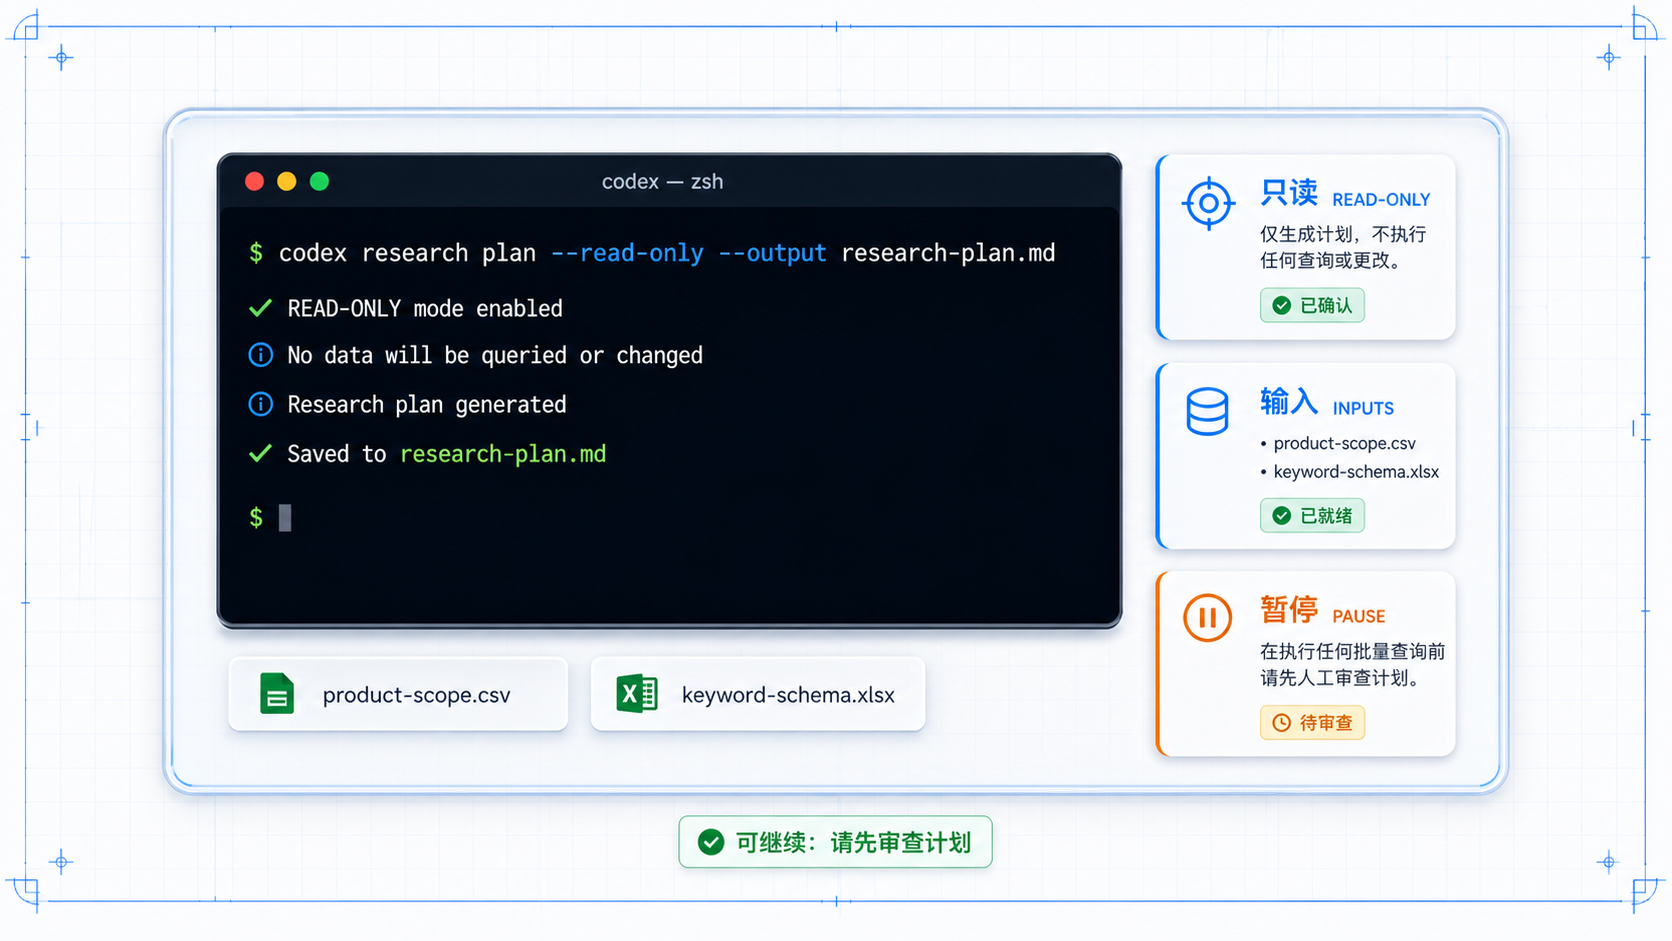
可以先让 Codex 只读这两个文件,只输出计划:
codex exec -s read-only -o research-plan.md "读取 product-scope.csv 和 keyword-schema.xlsx。先不要查询关键词。输出需要确认的业务问题、种子词来源、筛选规则、最终字段、验收方式,以及必须人工确认的步骤。"
这里有三个关键点:
-s read-only把研究阶段限制在只读沙箱里。Codex 可以读取资料、写出计划文件,但不能顺手修改产品范围。-o research-plan.md把计划保存为中间产物,方便人工审核,也方便下一次执行继续使用。- 先计划、后批量。如果计划漏了地区、客户类型,或出现根本不销售的产品线,应在查询开始前停下来修正。
把原始证据和工作判断分开
计划确认后,再分批处理关键词。每批记录都应留下来源 URL、查询时间、原始字段和无法确认的值。
建议将表格拆成两类字段:
原始证据:关键词、来源 URL、查询时间、原始 Volume、原始 KD、原始 Intent。
工作判断:建议页面类型、Topic Cluster、人工备注和状态。
原始证据必须能回到来源,工作判断必须能解释理由。两类信息混成一列“结论”,月底复盘时就只剩一张漂亮但无法追溯的表。
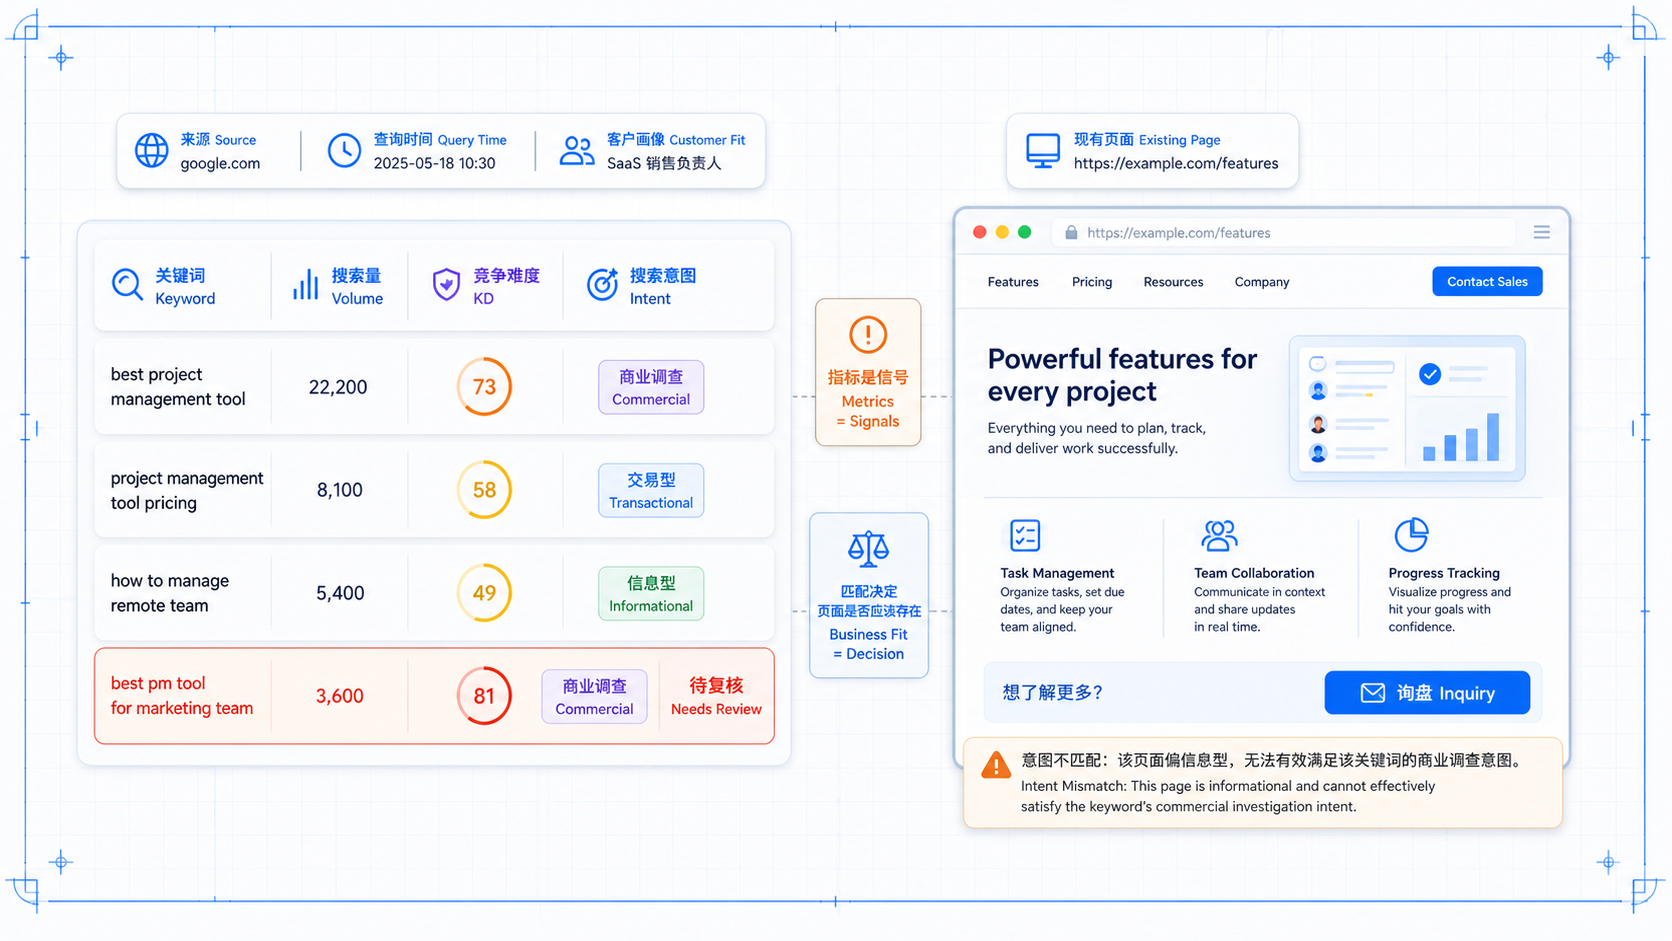
Semrush 等工具里的指标表达的是不同信号:
- Volume 说明搜索需求规模,不等于你的客户数量;
- KD 用来估计竞争难度,不等于新页面一定做不上去;
- Intent 是搜索目的分类,不等于页面已经知道如何承接访问者。
例如,industrial valve 可能是一个需求很大的词,但只做某种规格、只服务几个地区工厂的企业,未必应该围绕这个泛词建页面。客户采购路径、交付范围和页面上的询盘动作,才决定它是不是一个好选题。
抓取网页表格时还要防止列错位。多列数字被拍平成一串值后,表格看起来仍然整齐,实际可能每一行的含义都错了。可以先用页面外单独出现的一个值交叉核对列序,再接受整批数据;核不上的行直接标记为 needs-review,不要让模型用常识补空。
JSONL 解决交接,不解决判断
当 Codex 只输出自然语言,人可以阅读,下一个程序却很难稳定接手。需要把执行过程接进脚本时,可以使用 JSONL:
codex exec --json -s read-only -o research-result.md "检查 research/ 目录中的关键词记录,指出缺少来源 URL、查询时间或意图字段的行。"
--json 会把执行过程变成 JSONL 事件流,后续脚本可以按事件类型记录成功、失败和待复核项;-o 则保留最后的可读结果。
结构化输出只能让程序稳定接手,不能证明字段真实,也不能替你决定页面是否应该上线。权限也要单独设置:研究阶段使用只读,确实要改文件时再明确放开工作区范围。会跳过审批和沙箱的危险参数,不应出现在主力电脑的日常流程里。
聚类可以交给 AI,页面树要人工确认
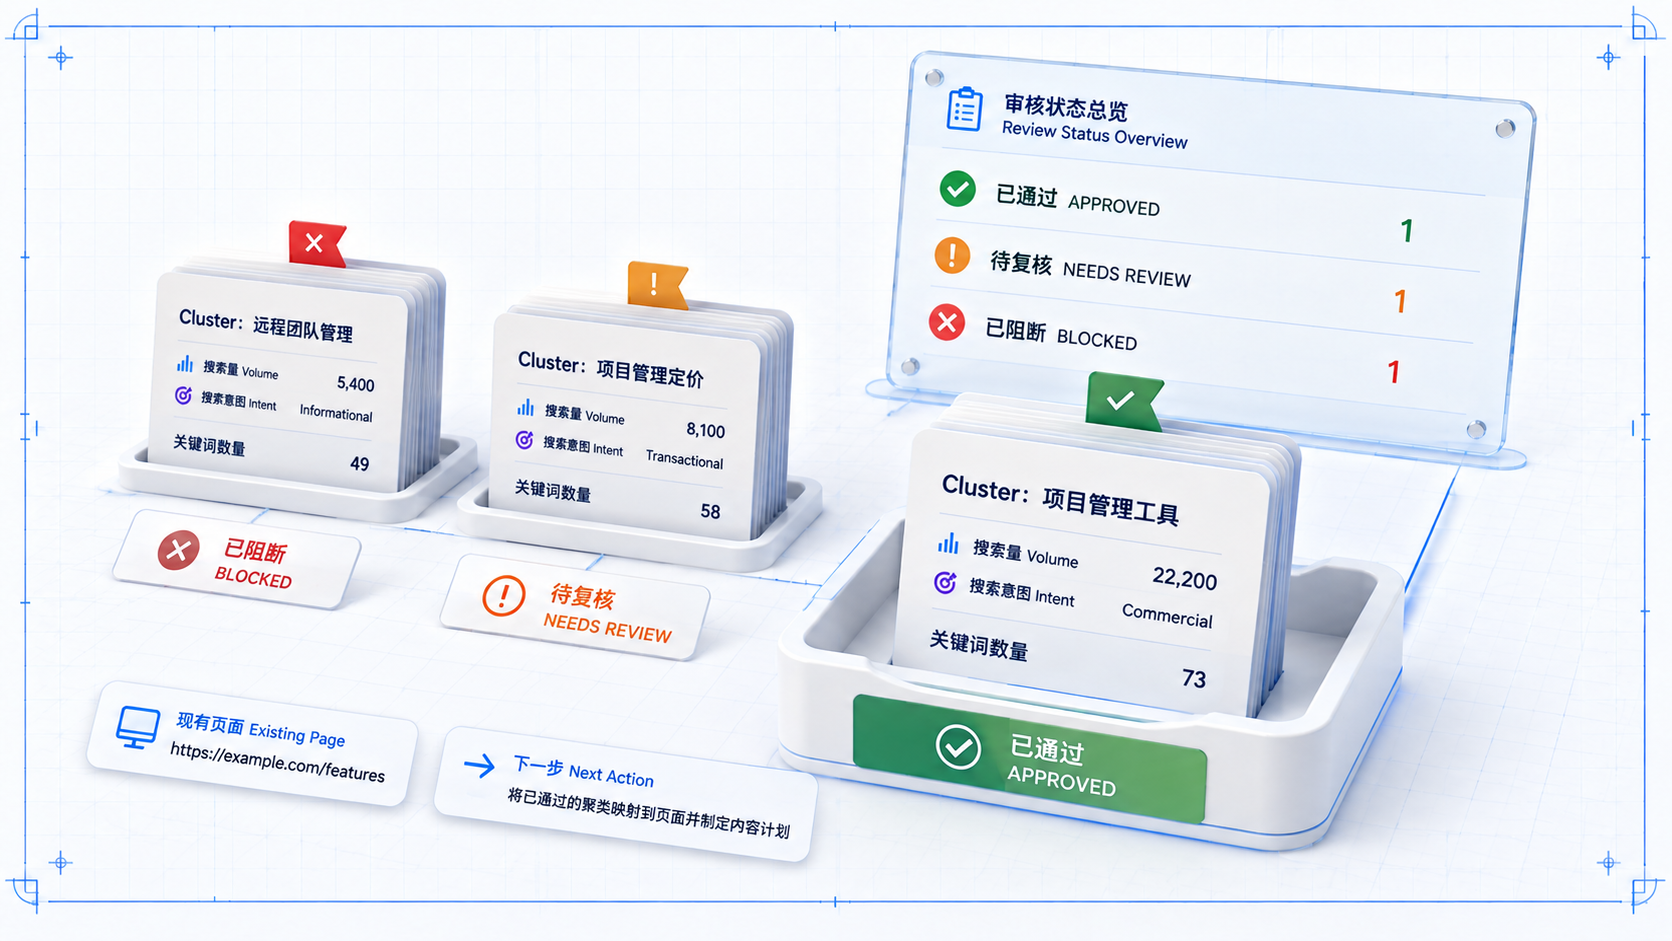
关键词变多后,Codex 可以按搜索意图和产品语境提出候选 Topic Cluster,并解释为什么把几组词放在一起,也可以列出每个 Cluster 可能对应的页面类型。
但页面规划应放进人工审核表,至少检查:
- 客户会不会这样搜:不是“看起来合理”,而是目标客户真的会用;
- 现有产品能不能交付:词再大,交付范围接不住,也不该为了流量建页面;
- 网站有没有现成承接页:新旧页面意图太近,可能互相竞争;
- 访问者下一步做什么:页面能否自然引导询盘、试用或注册。
其中一项答不上来,就保留候选状态。少发一页,也比一堆互相抢词的页面把站内结构做乱更好。
浏览器能取数,也会把误差带进来
如果环境接入浏览器工具,且账号拥有 Semrush 权限,Codex 可以协助点击页面、读取结果、保存截图和整理字段。但登录态、浏览器连接、站点改版和账号权限,都不是 Codex CLI 自己保证的。今天能看到的字段,下周可能换位置;一个账号能导出的数据,另一个账号未必有权限。
浏览器这一层适合只做三件事:
- 取数:保留原始页面和查询时间;
- 截图:记录关键表头和异常状态;
- 整理:将结果写入固定 schema。
涉及付费、导出客户数据或修改网站内容的操作,都应停在人工确认之前。浏览器自动化最危险的情况不是报错,而是静默完成了原本没打算做的动作。
一句话看清分工
人定义问题和边界,Codex 采集并整理证据,人根据业务做聚类和页面决策。
对独立站负责人,先准备产品范围文件,再让 Codex 生成研究计划,不要从“帮我做 SEO”开始。
对内容团队,最值得固定的是 schema、来源 URL 和查询时间。这样每次新增关键词,旧结论仍然可以追溯。
对 AI Agent 工作流,优先固定只读沙箱、输出文件、JSONL 事件和暂停点。它们比一个很长的 SEO Prompt 更能决定流程是否可复查。
Codex 可以帮你查词、搬数据、做初步聚类,甚至列出候选页面树;它不知道你的交付能力,也不会为错误页面负责。
结论
SEO 调研不适合追求“一键完成”。最适合自动化的是重复、规则明确、出错后容易回滚的动作;最不该自动化的是业务边界、页面取舍和上线确认。
可以先用一小批关键词跑通流程:计划能不能审、来源能不能回、字段会不会错位、needs-review 能不能被看见。等这条链稳定后,再接脚本、CI 或定时任务。顺序反过来,跑得越快,返工越多。