线上半夜报错的经历,写代码的多少都有过。
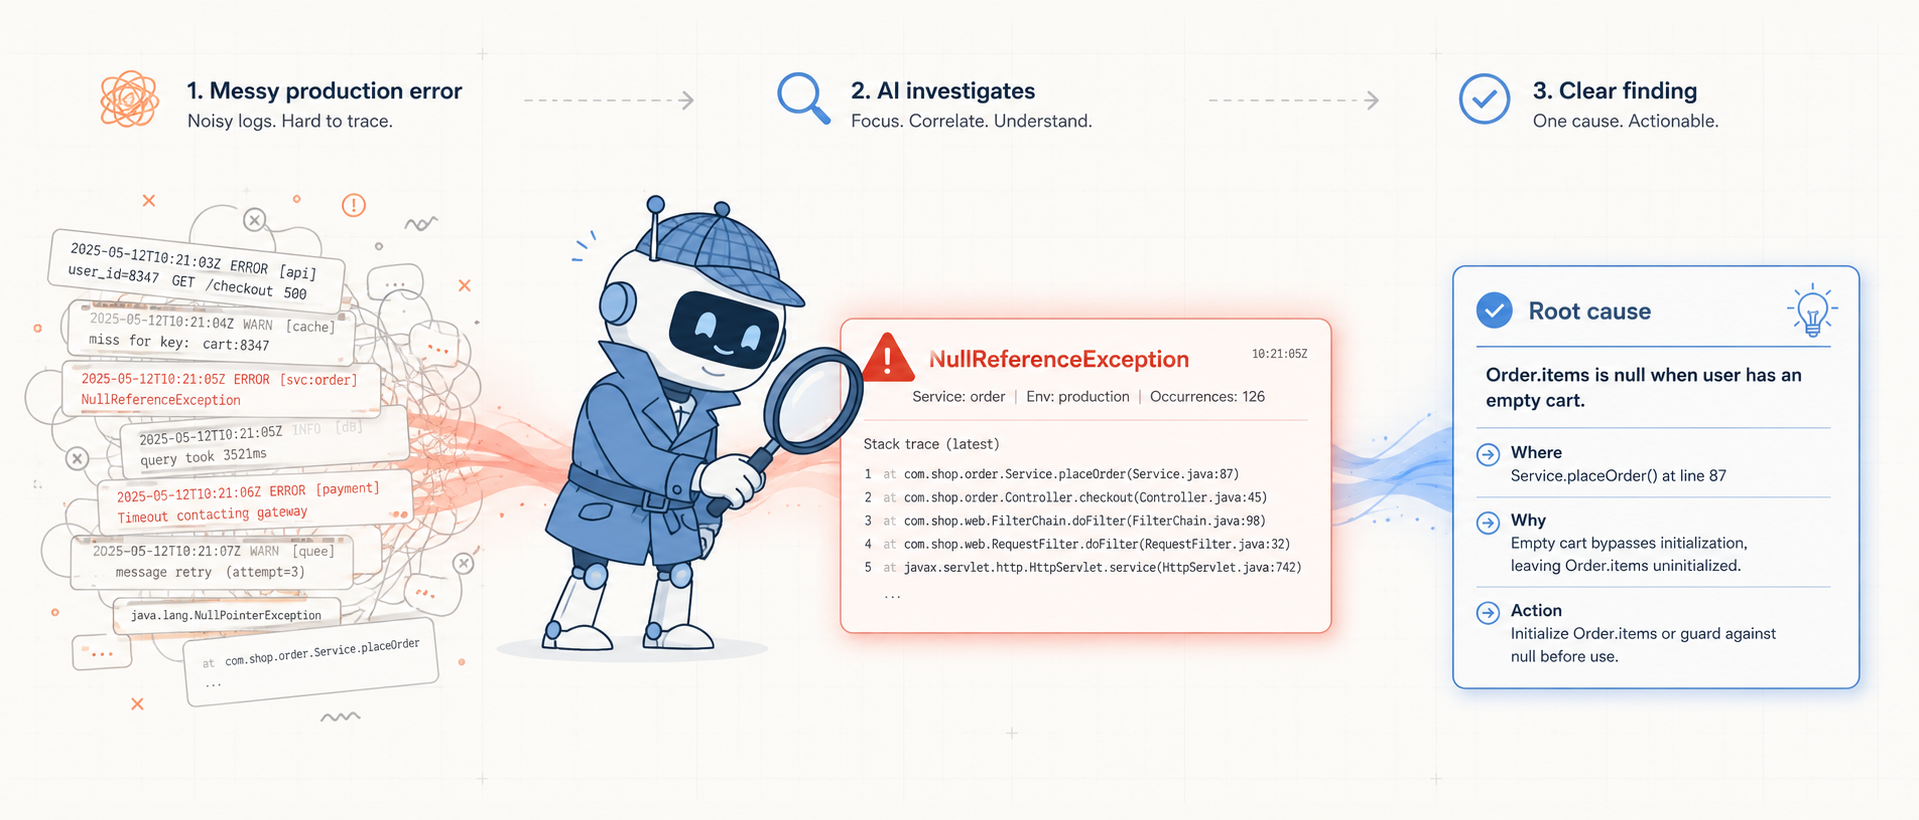
Sentry 上蹦出一个 issue,堆栈几十行,揉着眼睛顺着往下扒,哪个函数抛的、什么输入触发的、最近哪次提交动到了这块。
等你把上下文拼齐,天都快亮了。
最近试了个偷懒的办法,把这活的第一轮先交给 Codex,给它接上 Sentry,直接把出错的 issue 链接甩过去,让它去读堆栈、扒上下文、给我一个初步判断。
用下来的结论是,它没法替你拍板修复方案,但能把「从一条报错到搞清楚哪儿出了问题」这段最耗时的体力活,先替你干一遍。
打通的钥匙叫 MCP
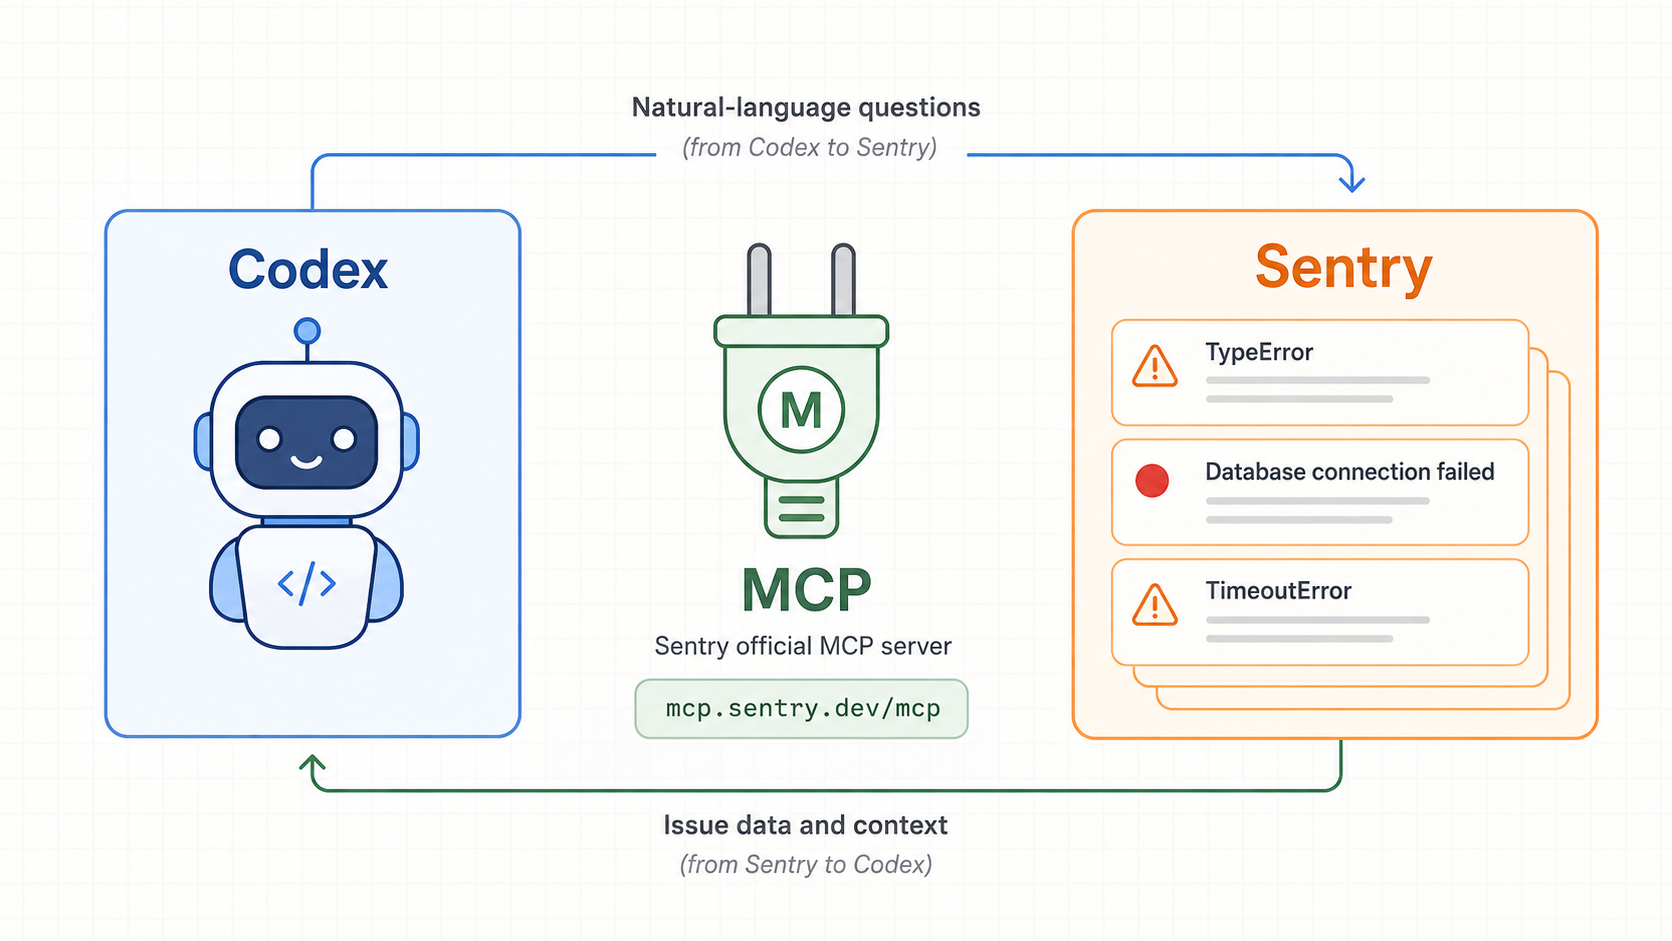
先说清楚一件事:Codex 不是天生就认识 Sentry,它俩之间隔着一层,这层叫 MCP。
可以把 MCP 理解成一个让 AI 工具接外部服务的通用插头标准。
Sentry 官方做了一个 MCP 服务,把自己的 API 包成 Codex 能调用的一组能力,接上之后,Codex 就能用自然语言去问 Sentry 数据,查 issue、读堆栈、看这个错误影响了多少用户,都行。
好处是这套东西不用你自己写胶水代码,Sentry 官方维护,Codex 官方支持,两边对接是现成的。
接起来只要一行命令
具体接法很简单。打开终端,跑这一句:
codex mcp add sentry --url <https://mcp.sentry.dev/mcp>
下次启动 Codex 的时候,Sentry 这个 MCP 服务就挂上了,它会自动弹出一个 OAuth 授权流程,让登录 Sentry 账号授权,这一步是让它拿到读项目数据的权限。
如果更习惯改配置文件,也可以直接编辑 ~/.codex/config.toml,加上这么一段:
[mcp_servers.sentry]
url = "<https://mcp.sentry.dev/mcp>"
保存好,重启一下正在跑的 Codex session 就生效了,效果和上面那条命令一样。
一条 issue 链接甩过去,它开始干活
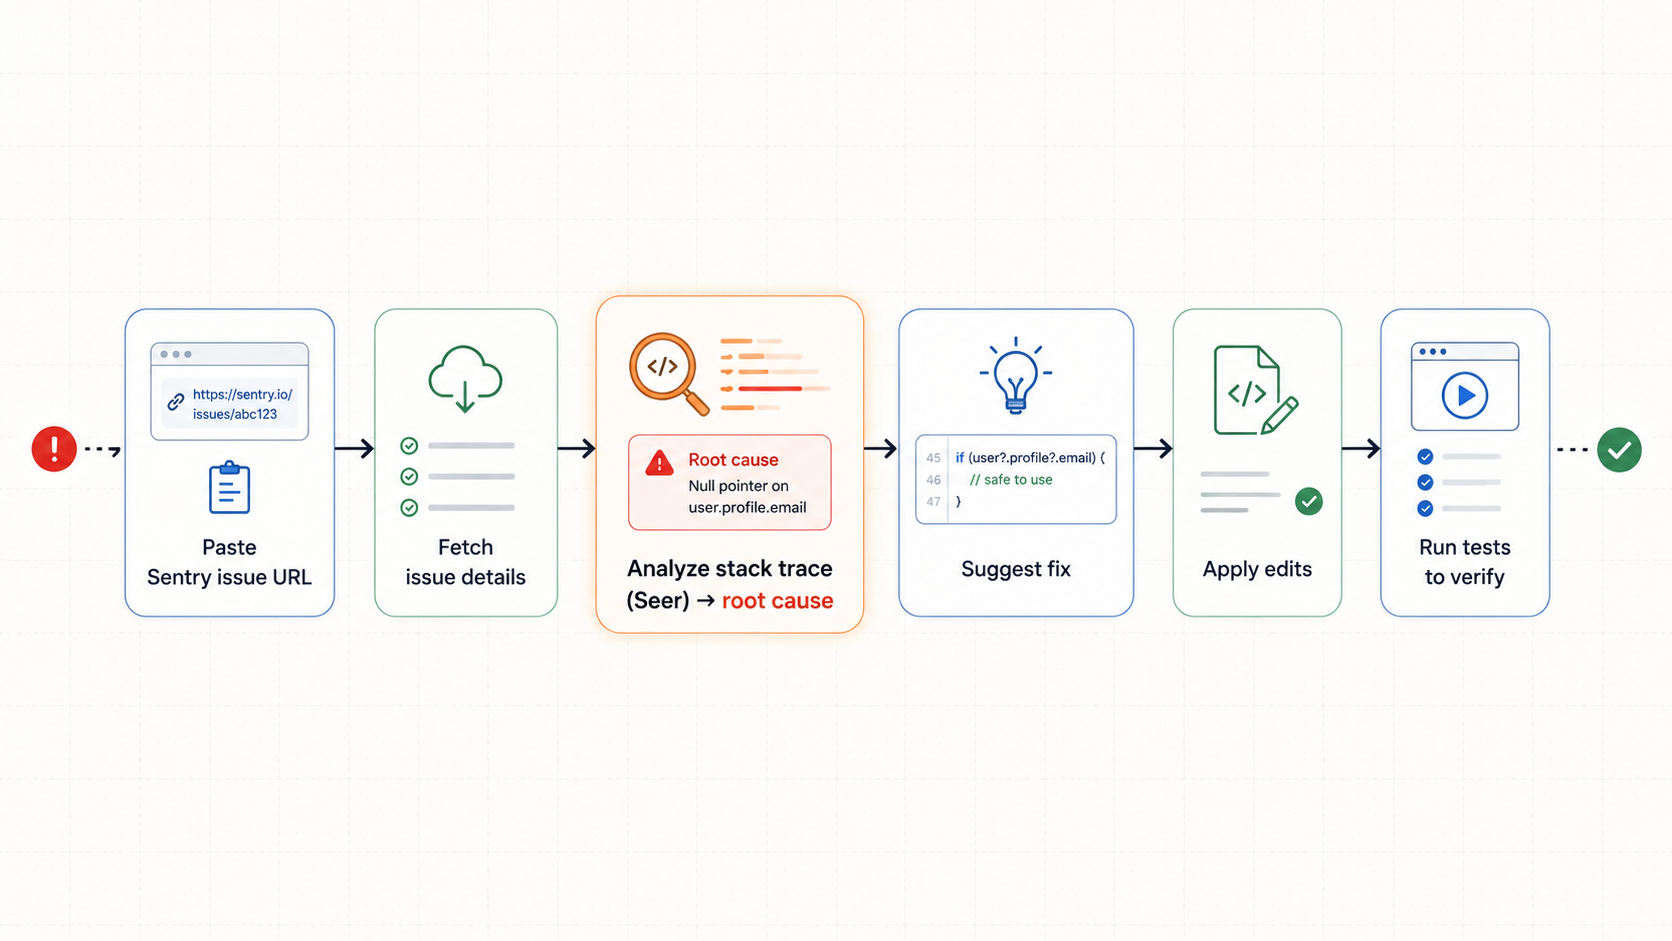
接好之后的用法非常直觉,从浏览器里把出错那个 issue 的 URL 复制下来,丢给 Codex,让它去查。 它接下来会做几件事,而且是自动一步接一步串起来的:
- 先 拉取 issue 详情——把这条报错的错误信息、堆栈、发生环境这些先抓下来。
- 再 分析堆栈、定位根因——这是 Sentry 比较能打的一点:它能调用 Sentry 自家的分析能力(Seer)去啃这段堆栈,而不是把几十行原样念给你听。
- 最后 给结论、甚至直接改——模型结合读到的上下文,告诉你问题可能出在哪、为什么,需要的话还能把建议的改法直接写进代码。
串起来就是:拉取 issue → 分析堆栈定位根因 → 给出方案 → 应用修改 → 跑测试验证。
你要做的,从「盯着几十行堆栈发懵」,变成「看它给的初步结论顺不顺」。
别让它把整个 Sentry 都翻个底朝天
有个细节值得单独拎出来说,尤其是团队用的时候,可以把它的活动范围锁死。 默认情况下它能看账号下的东西,范围偏大。 Sentry MCP 支持在连接的 URL 路径里加约束,把它限定在某个组织、甚至某个具体项目里:
- 只加组织:
/:organization - 精确到项目:
/:organization/:project加了约束之后,一些跨范围乱逛的工具会自动被藏掉,比如你限定了组织,它就不会再有列出所有组织那个能力了。 对生产环境来说,这种最小权限的做法比图省事全开要稳得多。
还有个「话痨模式」的取舍
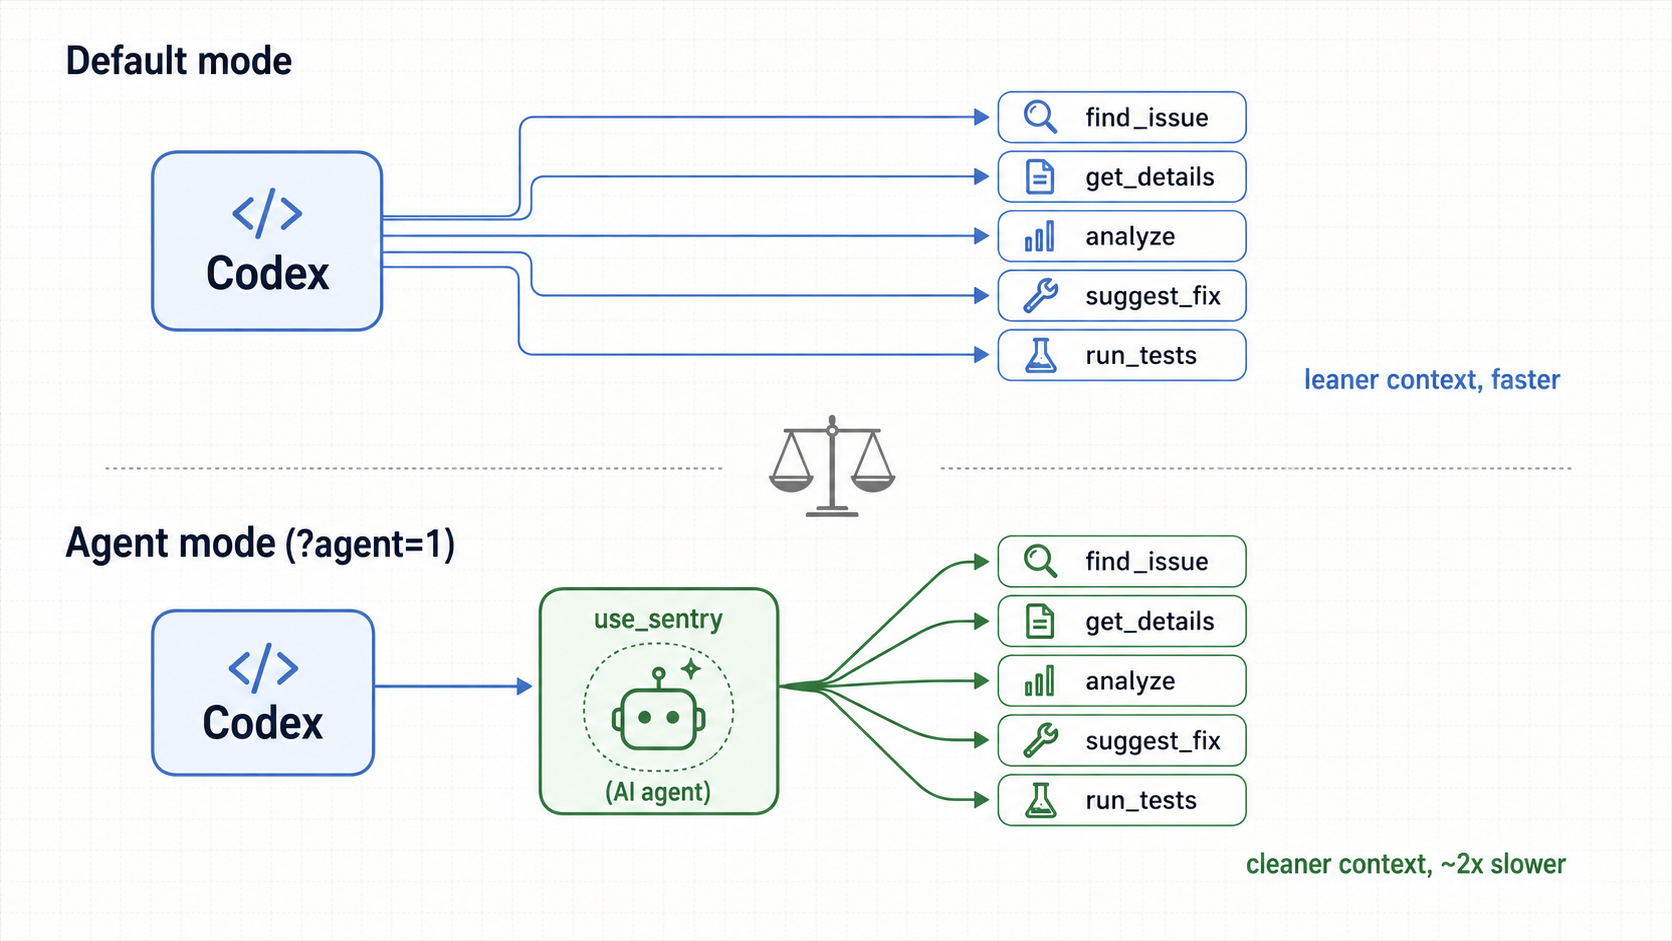
Sentry MCP 还提供了一个可选的 Agent Mode,在连接参数里加 ?agent=1 打开。
它的区别在于,平时 Codex 是直接看到 Sentry 给的一堆细分工具,自己挑着调;开了 agent mode 之后,Sentry 那边只暴露一个 use_sentry 的总入口,用自然语言提需求,由它内嵌的一个 AI 层去自动决定该调哪些工具、怎么串。
好处是你这边的上下文更干净,不用把一堆工具定义塞进去,代价也很实在,响应时间大约会翻倍,因为中间多了一层 AI 在做调度。
所以这个开关值不值得开,取决于更在意上下文占用还是响应速度,没有标准答案,自己权衡。
那到底「能不能先让 AI 排查」
回到标题这个问题,实际感受是:能,但要摆正它的位置。 它擅长的是那段机械又费神的前戏——把散落在 issue、堆栈、代码里的线索拉到一起,给你一个大概率是这儿、可能是这个原因的起点,这一步原本最吃时间,交给它确实省事,尤其是面对那种堆栈老长、你还不熟悉的模块。 但它给的是初步判断,不是最终答案,根因对不对、改法合不合理、会不会引入新问题,还得你这个懂业务的人来验,它把你从大海捞针直接送到验证一个假设,但按下就这么修的还是你。 所以线上报错的正确姿势不是甩给 AI 然后不管,而是让它先跑第一轮排查,你在它的结论上接着往下判断,省掉的是体力,保留的是判断,这个分工,跟它该有的样子是吻合的。
写在最后
值得提醒的一点是,让 AI 排查报错,靠不靠谱很大程度上取决于你的 Sentry 数据本身干不干净。堆栈完整、上报的上下文齐全,它才有料可分析;要是你的 issue 本身就缺胳膊少腿,那它也只能陪你一起猜,所以真要用好这套,反倒会倒逼你把 Sentry 的埋点和上报做扎实——这算是个意外的副作用。 说到底,线上报错最熬人的从来不是改,而是找,把找这段前戏交给一个不会犯困、不嫌堆栈长的 AI,哪怕它只对个七八成,剩下那两三成由你来兜——这种分工,比一个人从头扛到天亮,划算太多了。
参考来源
- Sentry MCP 官方页(含各客户端接入方式):https://mcp.sentry.dev